Claude Code'da verimi düşürmeden token tasarrufu
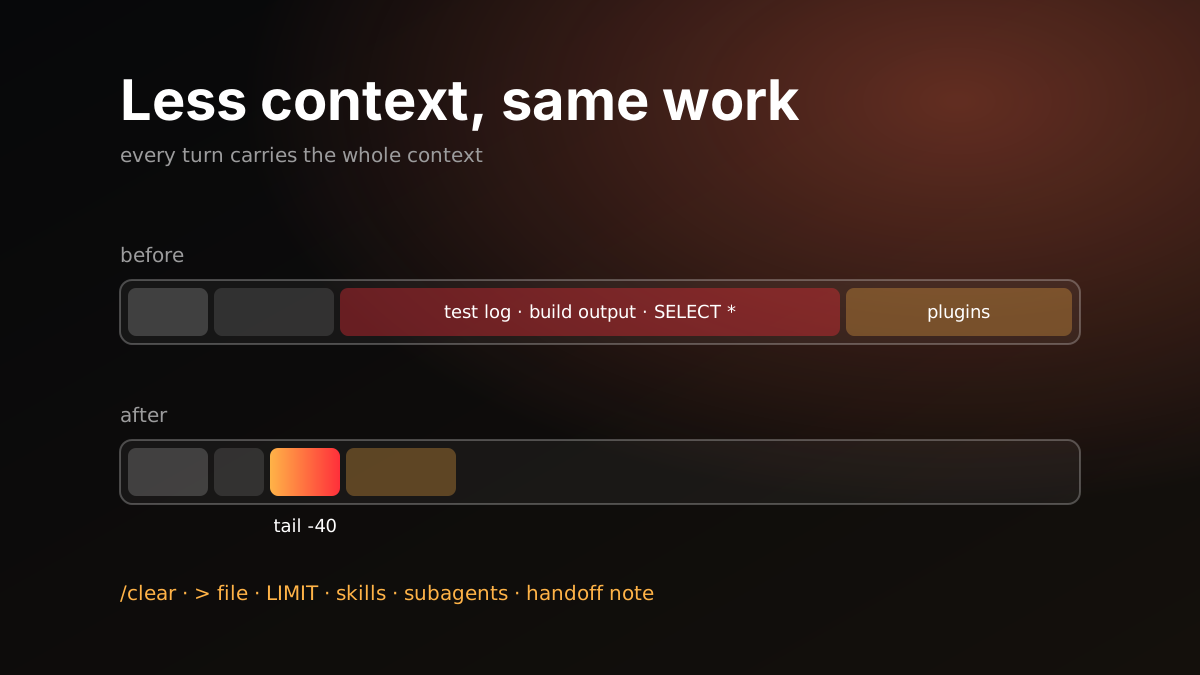
Claude Code’u birkaç hafta yoğun kullandıktan sonra limitlere daha sık takılmaya başladım. İlk tepki “daha az kullanayım” oluyor. Ama asıl sorun ne kadar kullandığım değil, token’ların nereye gittiğiydi. Çoğu, işe hiçbir şey katmayan yerlerde harcanıyordu.
Bu yazı, bende işe yarayan ayarları ve insanların çoğunlukla fark etmeden token harcadığı yerleri topluyor. Amaç daha az iş yaptırmak değil, aynı işi daha az bağlamla yaptırmak.
Önce bir gerçek: her tur, bütün bağlamı taşır
Modelin hafızası yok. Her mesajda o ana kadarki konuşmanın tamamı, yani sistem talimatları, araç tanımları, CLAUDE.md, okunan dosyalar ve komut çıktıları yeniden gönderiliyor. Önbellek bunun maliyetini düşürüyor ama sıfırlamıyor.
Bundan çıkan sonuç basit: bağlama giren her şey, oturum bitene kadar her turda tekrar ödenir. 50 satırlık bir log’a ihtiyacın varken 5.000 satırı okutursan, o 5.000 satırı sonraki her mesajda yeniden taşırsın.
Nereye gittiğini görmek için /context komutu bağlamın dökümünü, /cost ise oturumun harcamasını gösteriyor. Bir şey değiştirmeden önce bir kez bakmaya değer.
Fark etmeden token harcanan yerler
Birbiriyle ilgisiz işleri aynı oturumda yapmak
Sabah bir bug’a bakıp öğlen aynı oturumda yeni bir özelliğe geçince, bug’ın bütün izleri yeni işin her turunda taşınıyor. Üstelik model eski bağlamdan yanlış çıkarımlar da yapabiliyor.
Ne yapmalı: İş değişince /clear ile ya da yeni bir oturumla başla. Devam eden işler için bir sonraki bölümdeki devir notu yeterli.
Dev komut çıktıları
En büyük kaçak burası. Tipik örnekler:
- Bütün test suite’inin ayrıntılı çıktısı
npm installya da build log’uLIMITolmadan çalışan birSELECT *- Boyut sınırı olmayan bir log araması
- Bütün bir büyük dosyayı okumak
Ne yapmalı: Büyük çıktıyı dosyaya yaz, sadece gerekeni oku.
npm test > /tmp/test.log 2>&1; tail -40 /tmp/test.log
grep -n "FAIL" /tmp/test.log | head -20
Veritabanında önce COUNT(*) ya da gruplu bir özet sorgusu, sonra LIMIT’li bir örnek. Log aramalarında küçük bir sonuç sayısı ve sadece gereken alanlar. Büyük dosyalarda ilgili satır aralığı. Bunları CLAUDE.md’ye kısa kurallar olarak yazınca model kendiliğinden uyuyor.
Şişkin CLAUDE.md
CLAUDE.md her oturumun başında yükleniyor. Oraya eklenen her prosedür, onu hiç kullanmayan oturumlarda da ödeniyor. Zamanla “bir kere lazım olmuştu” notlarıyla yüzlerce satıra çıkabiliyor.
Ne yapmalı: CLAUDE.md’de sadece her oturumda geçerli olan kurallar kalsın. “Şu durumda şu adımları izle” türündeki prosedürleri skill’lere taşı. Skill’in sadece kısa açıklaması bağlamda durur, içeriği ihtiyaç olunca yüklenir.
Kullanılmayan ve tekrarlayan eklentiler
Her MCP sunucusu, her eklenti bağlama bir şeyler ekliyor: araç tanımları, talimatlar, bazen her oturumun başında çalışan bir hook’un çıktısı. Bende aynı işi yapan iki eklentinin iki kopyası ve hiç kullanmadığım bir dokümantasyon sunucusu vardı.
Ne yapmalı: Eklenti listeni gözden geçir. Aynı işi yapanlardan birini bırak, kullanmadıklarını kapat. Sadece belirli bir projede lazım olanları global ayarlar yerine o projenin .claude/settings.json dosyasında aç.
Her iş için en güçlü model
Bir metni düzeltmek, bir dosyayı yeniden adlandırmak ya da planı hazır bir görevi uygulamak için en güçlü model gerekmiyor.
Ne yapmalı: Varsayılanı orta seviye bir model yap. En güçlü modeli plan, zor hata ayıklama ve son review gibi düşünme gerektiren işlere sakla. Subagent’lara da işine uygun model ver. Aynı mantık düşünme seviyesi (effort) için de geçerli: basit işte yüksek effort, sadece daha uzun bir cevap demek.
Ana oturumda geniş keşif
“Bu projede kimlik doğrulama nasıl çalışıyor?” diye sorunca model onlarca dosyayı ana bağlama okuyabiliyor. Cevabı aldıktan sonra o dosyaların hepsi bağlamda kalıyor.
Ne yapmalı: Geniş aramaları bir subagent’a ver. Subagent dosyaları kendi bağlamında okur, ana oturuma sadece sonucu döner. Ya da dosya yolunu zaten biliyorsan doğrudan onu söyle.
Belirsiz istekler
“Şu hatayı düzelt” demek, modelin önce hatanın nerede olduğunu aramasına yol açıyor. “src/api/orders.ts içindeki calculateTotal, indirim null olunca çöküyor” demek aramayı atlatıyor.
Ne yapmalı: Bildiğin bağlamı ver: dosya, fonksiyon, hata mesajı, beklenen davranış. Kısa bir cümle, birkaç tur keşiften ucuz.
Sohbete yapıştırılan dev metinler
Bütün bir stack trace’i ya da log dosyasını sohbete yapıştırmak, onu kalıcı olarak bağlama koymak demek.
Ne yapmalı: Dosyaya kaydet ve yolunu ver. Model ihtiyacı olan kısmı okur.
Ekran görüntüsüyle doğrulama
Görseller ciddi token tutuyor. Bir sayfada bir metnin olup olmadığını kontrol etmek için ekran görüntüsü almak pahalı bir yol.
Ne yapmalı: Metin ve yapı için sayfanın metnini ya da erişilebilirlik ağacını oku. Ekran görüntüsünü gerçekten görsel bir şeyi kontrol ederken kullan.
Tekrar deneme döngüleri
Bir komut başarısız olunca model küçük değişikliklerle tekrar tekrar deneyebiliyor. Her deneme bir tur, her tur bütün bağlam.
Ne yapmalı: İki başarısız denemeden sonra dur ve yön ver. Sorun çoğu zaman modelin göremediği bir yerde oluyor: yetki, ortam, sürüm farkı.
Gereğinden büyük çoklu ajan işleri
Paralel çalışan onlarca ajan etkileyici görünüyor, ama her biri kendi bağlamını yüklüyor. Beş ajanın yapabileceği bir review’u yirmi ajana yaptırmak, dört kat token demek.
Ne yapmalı: Çoklu ajan işlerine bir boyut sınırı koy. Claude Code’da bunun için bir ayar da var. Ben varsayılanı “küçük” yaptım.
Sık tekrarlanan arka plan kontrolleri
Bir CI işini ya da deploy’u her dakika kontrol ettirmek, her kontrolde bağlamı yeniden taşımak demek.
Ne yapmalı: Kontrol aralığını işin gerçek süresine göre seç. Sekiz dakika süren bir CI için tek bir kontrol, sekiz kontrolden iyidir.
Uzun işlerde: devir notu
Bazı işler tek oturuma sığmıyor. Bağlam dolunca otomatik sıkıştırma devreye giriyor, ama neyin önemli olduğuna o karar veriyor.
Bunun yerine iş kilometre taşlarında kısa bir devir notu yazdırıyorum: ne yapıldı, hangi kararlar verildi, sırada ne var, hangi dosyalar önemli. Sonra yeni bir oturum açıp sadece o notu okutuyorum. Yeni oturum, yüzlerce turluk geçmiş yerine bir sayfalık özetle başlıyor.
Bunu bir skill’e çevirmek işi tek komuta indiriyor. Not, repo içinde sabit bir klasöre yazılıyor, böylece bir sonraki oturum nereye bakacağını biliyor.
Kısa kontrol listesi
- İş değişince
/clearya da yeni oturum. - Büyük çıktı dosyaya, sadece gereken kısmı bağlama.
- Sorgularda önce özet, sonra
LIMIT. Log aramalarında boyut sınırı. CLAUDE.mdkısa, prosedürler skill’de.- Kullanılmayan ve tekrarlayan eklentiler kapalı. Projeye özel olanlar proje ayarında.
- Varsayılan orta model. Güçlü model plan ve review için.
- Geniş keşif subagent’ta.
- İstekte dosya ve fonksiyon adı.
- Metin varken ekran görüntüsü yok.
- İki başarısız denemeden sonra müdahale.
- Çoklu ajan işlerinde boyut sınırı.
- Uzun işlerde devir notu ve temiz oturum.
Bunların hiçbiri modelin yaptığı işi azaltmıyor. Sadece modelin her turda taşıdığı yükü azaltıyor. Bende limitlere takılma sıklığı belirgin şekilde düştü, çıktının kalitesinde bir fark görmedim.